
Коэффициент детерминации изменяется в. Формула коэффициента детерминации, что измеряет
Предположим, что экономические предпосылки и анализ расположения точек на корреляционном поле позволил нам выдвинуть гипотезу о том, что зависимость результирующего признака у от фактора х может быть описана следующей моделью:
Причем, как не раз мы уже отмечали коэффициенты 0 и 1 в этом уравнении неизвестны. Используя МНК, мы можем найти оценки этих коэффициентов в 0 и в 1 и записать следующее выражение для у:
На приведенном рисунке (Рис.4) изображены фактические значения переменной у, график гипотетической функции регрессии (которая, вообще говоря, нам неизвестна!) и график эмпирической функции регрессии, коэффициенты которой найдены из условия минимума суммы квадратов ошибок.
Рис.4.
Исходя из логики наших действий, возникают два вопроса:
- ?Можно ли с той или иной вероятностью найти подтверждение, что вид функциональной зависимости (речь пока идет только о линейной функции) выбран корректно.
- ?Насколько хорошо, со статистической точки зрения, оценки неизвестных параметров, полученные по МНК, приближают неизвестные коэффициенты.
Для ответов на поставленные вопросы нам понадобится, в частности, понятие коэффициента детерминации. Перед тем как ввести это понятие рассмотрим следующую сумму:
Покажем, что ее можно представить в виде:
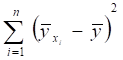
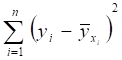
Действительно,
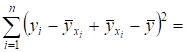

Через обозначена функция регрессии, полученная по МНК: .
Покажем, что последнее слагаемое в (1) равно нулю, для этого запишем его в виде:
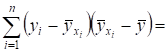
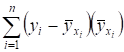
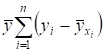
Рассмотрим слагаемое
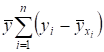
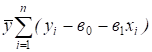
В силу равенства (2), можно утверждать, что оно равно 0. Преобразуем теперь первое слагаемое:
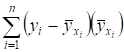
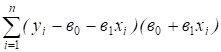
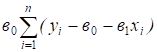
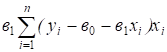
Оба слагаемых равны нулю в силу равенств (2) и (3).
Таким образом, мы показали, что имеет место, следующее представление для рассматриваемой суммы:
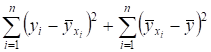
Величину е i равную:
будем называть остатком. Следовательно, первое слагаемое в правой части (2) есть сумма квадратов остатков:
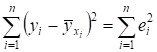
Ее называют остаточной суммой квадратов и обозначают RSS (residual sum of squares).
Вторая сумма это сумма квадратов отклонений точек, расположенных на регрессионной прямой от прямой у =. Эту сумму называют суммой квадратов отклонений, объясненной регрессией ЕSS (explained sum of squares).
В левой части равенства (2) находится сумма квадратов отклонений фактических значений переменной у от прямой у =. Такую сумму называют полной суммой квадратов и обозначают TSS (total sum of squares).
Таким образом, полная сумма квадратов TSS разбилась на две составляющие:
TSS= RSS+ ESS. (3)
- ? ESS- сумму квадратов, обусловленных влиянием основного фактора х;
- ? RSS - сумму квадратов, обусловленных влиянием других, в том числе и случайных факторов.
Замечание 1. Следует иметь в виду, что в литературе по эконометрике, в частности в , эту же систему обозначений используют с точностью до наоборот, давая ей другое объяснение. Сумму, которая выше обозначена как ЕSS обозначают через RSS и расшифровывают так: regression sum of squares. И наоборот, сумму, обозначенную нами как RSS называют ЕSS: error sum of squares. Мы будем придерживаться введенной выше терминологии. ^
Замечание 2.Рассмотрим два частных случая. Предположим, что x не оказывает никакого влияния на y, тогда выборочное условное среднее совпадает с выборочным средним, в такой ситуации ЕSS =0 и
В том случае, когда на зависимую переменную у не оказывает влияния никакие другие факторы, кроме х, сумма RSS будет равняться нулю и будет выполняться следующее равенство:
В общем же случае, если оценки параметров функции регрессии найдены по МНК, всегда будет иметь место равенство (3).^
Определение 1. Парным коэффициентом детерминации (выборочным) называют отношение:
Говорят, что «коэффициент детерминации показывает, какая доля дисперсии величины y определяется (детерминируется) изменчивостью (дисперсией) соответствующей функции регрессии y от x» .
Поясним сказанное. Для этого вернемся к равенству (2) и разделим обе части равенства на n, получим:
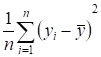
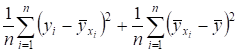

Тогда выражение для парного коэффициента детерминации можно представить в виде:
Следует отметить, что введенный нами парный коэффициент детерминации также относится к выборочным числовым характеристикам и рассчитывается по эмпирическим данным. Теоретический коэффициент детерминации будем обозначать R xy .
Рассмотрим, в каком диапазоне изменяется значение коэффициента детерминации. Очевидно, что эта величина всегда неотрицательна. Найдем верхнюю границу. Из равенства (3) следует следующее равенство:

Следовательно,

Отсюда очевидно, что в силу того, что наименьшее значение RSS =0, наибольшее значение коэффициента детерминации равно 1. Таким образом,
Отметим, что значение коэффициента детерминации тем ближе к 1, чем меньше остаточная сумма квадратов. В этом случае говорят, что уравнение регрессии статистически значимо и фактор х оказывает сильное воздействие на результирующий признак у (последний тезис справедлив только для модели парной линейной регрессии!).
Покажем, как связаны коэффициент парной детерминации с выборочным коэффициентом корреляции, чтобы аргументировать последнее утверждение.
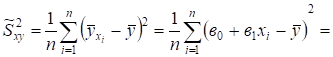
Подставим это выражение в числитель формулы (5):
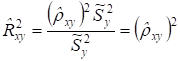
Следовательно, в случае парной линейной регрессии, коэффициент детерминации равен квадрату выборочного коэффициента корреляции:
Замечание 1. Из теории вероятностей известно следующее свойство коэффициента корреляции. Коэффициент корреляции двух случайных величин равен 1 или -1 тогда и только тогда, когда случайные величины связаны между собой линейно, т.е. у = ах + в. Классификация силы связи двух случайных величин в зависимости от величины коэффициента корреляции (теоретического!) может производиться следующим образом.
Если то связь между случайными величинами классифицируют как слабую; если то силу связи между двумя случайными величинами классифицируют как среднюю и, наконец, если, то говорят, что имеет место сильная стохастическая зависимость. Причем, если коэффициент корреляции положительный, то связь классифицируют как прямую, то есть значение обеих случайных величин увеличиваются, или уменьшаются одновременно. Отрицательное значение коэффициента корреляции говорит об обратной связи, то есть, например, увеличение значений одной случайной величины ведет к уменьшению значений другой. Следует иметь в виду, что использование выборочного коэффициента корреляции для подобной классификации, требует вдумчивого подхода. Эта характеристика является по своей сути случайной величиной и нельзя по ее значению делать категоричные выводы, подобные тем, которые производят, ориентируясь на. Все суждения, должны носить уже в этом случае более осторожный характер.
Тем не менее, и выборочный коэффициент корреляции и парный коэффициент детерминации служат хорошим индикатором, позволяющим нам делать предположение о том, что зависимость между х и у имеет место, и она носит вид линейной функциональной зависимости.
Вернемся к парному коэффициенту детерминации. Если модуль выборочного коэффициента корреляции близок к 1, то из формулы (6) следует, что близок к 1 и. Таким образом, близость коэффициента детерминации или абсолютной величины выборочного коэффициента корреляции к 1, служит ещё одним основанием в поддержку предположения, что функция регрессии линейна.
При анализе модели парной линейной регрессии будем делать следующие предварительные выводы о качестве модели.
- ?Если , то будем считать, что использование регрессионной модели для аппроксимации зависимости между у и х статистически необоснованно.
- ?Если (0,09; 0,49], то использование регрессионной модели возможно, но после оценивания параметров, модель подлежит дальнейшему многостороннему статистическому анализу.
- ?Если (0,49; 1], то будем считать, что у нас есть основания для использования регрессионной модели, при анализе поведения переменной у.
Пример 1. Вычислим коэффициент детерминации и сделаем предварительный вывод о качестве аппроксимации доходности акций компании Glenwood City Properties моделью линейной регрессии (пример 1).
Решение. Так как значение выборочного коэффициента корреляции нам уже известно, то для нахождения воспользуемся формулой (6):
И значение, и значение, говорят о слабой зависимости между доходностью рыночного индекса и доходностью акций указанной компании. Такая слабая зависимость обычно характерна для компаний с низкой рыночной капитализацией, которые не участвуют в формировании рыночного индекса. ^
Так, например, индекс S&P 500 (Standard & Poors Stock Price Index) представляет средневзвешенную величину курсов акций 500 наиболее крупных компаний. Наиболее часто цитируемым рыночным индексом является индекс Доу Джонса (DJIA), основанный на показателях всего 30 акций. Впервые этот индекс был вычислен в 1884 как среднеарифметическое 11 акций, с 1928 для расчета индекса используется 30 ценных бумаг. Состав бумаг, входящих в индекс, периодически меняется.
Сегодня уже все, кто хоть немного интересуется дата майнингом, наверняка слышали про простую линейную регрессию . Про нее уже писали на хабре, а также подробно рассказывал Эндрю Нг в своем известном курсе машинного обучения. Линейная регрессия является одним из базовых и самых простых методов машинного обучения, однако очень редко упоминаются методы оценки качества построенной модели. В этой статье я постараюсь немного исправить это досадное упущение на примере разбора результатов функции summary.lm() в языке R. При этом я постараюсь предоставить необходимые формулы, таким образом все вычисления можно легко запрограммировать на любом другом языке. Эта статья предназначена для тех, кто слышал о том, что можно строить линейную регрессию, но не сталкивался со статистическими процедурами для оценки ее качества.Модель линейной регрессии
Итак, пусть есть несколько независимых случайных величин X1, X2, ..., Xn (предикторов) и зависящая от них величина Y (предполагается, что все необходимые преобразования предикторов уже сделаны). Более того, мы предполагаем, что зависимость линейная, а ошибки рапределены нормально, то естьГде I - единичная квадратная матрица размера n x n.
Итак, у нас есть данные, состоящие из k наблюдений величин Y и Xi и мы хотим оценить коэффициенты. Стандартным методом для нахождения оценок коэффициентов является метод наименьших квадратов . И аналитическое решение, которое можно получить, применив этот метод, выглядит так:
где b
с крышкой - оценка вектора коэффициентов, y
- вектор значений зависимой величины, а X - матрица размера k x n+1 (n - количество предикторов, k - количество наблюдений), у которой первый столбец состоит из единиц, второй - значения первого предиктора, третий - второго и так далее, а строки соответствуют имеющимся наблюдениям.
Функция summary.lm() и оценка получившихся результатов
Теперь рассмотрим пример построения модели линейной регрессии в языке R:> library(faraway) > lm1<-lm(Species~Area+Elevation+Nearest+Scruz+Adjacent, data=gala) > summary(lm1) Call: lm(formula = Species ~ Area + Elevation + Nearest + Scruz + Adjacent, data = gala) Residuals: Min 1Q Median 3Q Max -111.679 -34.898 -7.862 33.460 182.584 Coefficients: Estimate Std. Error t value Pr(>|t|) (Intercept) 7.068221 19.154198 0.369 0.715351 Area -0.023938 0.022422 -1.068 0.296318 Elevation 0.319465 0.053663 5.953 3.82e-06 *** Nearest 0.009144 1.054136 0.009 0.993151 Scruz -0.240524 0.215402 -1.117 0.275208 Adjacent -0.074805 0.017700 -4.226 0.000297 *** --- Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1 Residual standard error: 60.98 on 24 degrees of freedom Multiple R-squared: 0.7658, Adjusted R-squared: 0.7171 F-statistic: 15.7 on 5 and 24 DF, p-value: 6.838e-07
Таблица gala содержит некоторые данные о 30 Галапагосских островах. Мы будем рассматривать модель, где Species - количество разных видов растений на острове линейно зависит от нескольких других переменных.
Рассмотрим вывод функции summary.lm().
Сначала идет строка, которая напоминает, как строилась модель.
Затем идет информация о распределении остатков: минимум, первая квартиль, медиана, третья квартиль, максимум. В этом месте было бы полезно не только посмотреть на некоторые квантили остатков, но и проверить их на нормальность, например тестом Шапиро-Уилка.
Далее - самое интересное - информация о коэффициентах. Здесь потребуется немного теории.
Сначала выпишем следующий результат:
при этом сигма в квадрате с крышкой является несмещенной оценкой для реальной сигмы в квадрате. Здесь b
- реальный вектор коэффициентов, а эпсилон с крышкой - вектор остатков, если в качестве коэффициентов взять оценки, полученные методом наименьших квадратов. То есть при предположении, что ошибки распределены нормально, вектор коэффициентов тоже будет распределен нормально вокруг реального значения, а его дисперсию можно несмещенно оценить. Это значит, что можно проверять гипотезу на равенство коэффициентов нулю, а следовательно проверять значимость предикторов, то есть действительно ли величина Xi сильно влияет на качество построенной модели.
Для проверки этой гипотезы нам понадобится следующая статистика, имеющая распределение Стьюдента в том случае, если реальное значение коэффициента bi равно 0:
где


Теперь все готово для продолжения разбора вывода функции summary.lm().
Итак, далее идут оценки коэффициентов, полученные методом наименьших квадратов, их стандартные ошибки, значения t-статистики и p-значения для нее. Обычно p-значение сравнивается с каким-нибудь достаточно малым заранее выбранным порогом, например 0.05 или 0.01. И если значение p-статистики оказывается меньше порога, то гипотеза отвергается, если же больше, ничего конкретного, к сожалению, сказать нельзя. Напомню, что в данном случае, так как распределение Стьюдента симметричное относительно 0, то p-значение будет равно 1-F(|t|)+F(-|t|), где F - функция распределения Стьюдента с k-n-1 степенями свободы. Также, R любезно обозначает звездочками значимые коэффициенты, для которых p-значение достаточно мало. То есть, те коэффициенты, которые с очень малой вероятностью равны 0. В строке Signif. codes как раз содержится расшифровка звездочек: если их три, то p-значение от 0 до 0.001, если две, то оно от 0.001 до 0.01 и так далее. Если никаких значков нет, то р-значение больше 0.1.
В нашем примере можно с большой уверенностью сказать, что предикторы Elevation и Adjacent действительно с большой вероятностью влияют на величину Species, а вот про остальные предикторы ничего определенного сказать нельзя. Обычно, в таких случаях предикторы убирают по одному и смотрят, насколько изменяются другие показатели модели, например BIC или Adjusted R-squared, который будет разобран далее.
Значение Residual standart error соответствует просто оценке сигмы с крышкой, а степени свободы вычисляются как k-n-1.
А теперь самая важные статистики, на которые в первую очередь стоит смотреть: R-squared и Adjusted R-squared:
где Yi - реальные значения Y в каждом наблюдении, Yi с крышкой - значения, предсказанные моделью, Y с чертой - среднее по всем реальным значениям Yi.


Начнем со статистики R-квадрат или, как ее иногда называют, коэффициента детерминации. Она показывает, насколько условная дисперсия модели отличается от дисперсии реальных значений Y. Если этот коэффициент близок к 1, то условная дисперсия модели достаточно мала и весьма вероятно, что модель неплохо описывает данные. Если же коэффициент R-квадрат сильно меньше, например, меньше 0.5, то, с большой долей уверенности модель не отражает реальное положение вещей.
Однако, у статистики R-квадрат есть один серьезный недостаток: при увеличении числа предикторов эта статистика может только возрастать. Поэтому, может показаться, что модель с большим количеством предикторов лучше, чем модель с меньшим, даже если все новые предикторы никак не влияют на зависимую переменную. Тут можно вспомнить про принцип бритвы Оккама . Следуя ему, по возможности, стоит избавляться от лишних предикторов в модели, поскольку она становится более простой и понятной. Для этих целей была придумана статистика скорректированный R-квадрат. Она представляет собой обычный R-квадрат, но со штрафом за большое количество предикторов. Основная идея: если новые независимые переменные дают большой вклад в качество модели, значение этой статистики растет, если нет - то наоборот уменьшается.
Для примера рассмотрим ту же модель, что и раньше, но теперь вместо пяти предикторов оставим два:
> lm2<-lm(Species~Elevation+Adjacent, data=gala)
> summary(lm2)
Call:
lm(formula = Species ~ Elevation + Adjacent, data = gala)
Residuals:
Min 1Q Median 3Q Max
-103.41 -34.33 -11.43 22.57 203.65
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 1.43287 15.02469 0.095 0.924727
Elevation 0.27657 0.03176 8.707 2.53e-09 ***
Adjacent -0.06889 0.01549 -4.447 0.000134 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 60.86 on 27 degrees of freedom
Multiple R-squared: 0.7376, Adjusted R-squared: 0.7181
F-statistic: 37.94 on 2 and 27 DF, p-value: 1.434e-08
Как можно увидеть, значение статистики R-квадрат снизилось, однако значение скорректированного R-квадрат даже немного возросло.
Теперь проверим гипотезу о равенстве нулю всех коэффициентов при предикторах. То есть, гипотезу о том, зависит ли вообще величина Y от величин Xi линейно. Для этого можно использовать следующую статистику, которая, если гипотеза о равенстве нулю всех коэффициентов верна, имеет
Суть состоит в следующем: этот показатель измеряет меру зависимости вариации одной величины от многих других. Он применяется для оценки качества линейной регрессии.
Формула расчета:
R^2 \equiv 1-{\sum_i (y_i — f_i)^2 \over \sum_i (y_i-\bar{y})^2},
- \bar{y} – ср. арифметическое зависимой переменной;
- fi – знач. зависимой переменной, предполагаемое по уравнению регрессии;
- yi – значение исследуемой зависимой переменной.
Детерминация, что это такое — определение
Коэффициент детерминации – часть дисперсии переменной (зависимой), которая обуславливается конкретной моделью зависимости. Так эта единица поможет вычесть долю необъясненной дисперсии в дисперсии зависимой переменной.
Данный показатель может принимать значения в пределах от 0 до 1. Чем его значение ближе к 1, тем связаннее результативный признак с исследуемыми факторами.
Т.к. преступление является результатом связи поведения и личностных качеств, этот показатель в деятельности заинтересованных органов рассчитывается для оценки качества преступного поведения, дает представление, что послужило вероятностной причиной преступления, что является мотивацией, какие этому были причины и условия.
Коэффициент детерминации, что показывает?
Этот коэффициент показывает варианты результативного признака от влияния факторного признака, он тесно связан с числом корреляции. Если связь отсутствует, то показатель равняется нулю, при ее наличии – единице.
Есть определение детерминизма как принципа устройства мира. Основой этого представления является взаимосвязанность всех явления. Это учение отрицает существование вещей вне взаимосвязи с миром.
Противоположностью является индетерминизм, он связан с отрицанием объективных отношений детерминации, или отрицанием причинности.
Генетический детерминизм – вера в то, что любой организм развивается под генетическим контролем.
Под детерминантами преступности в криминологии понимают социальные явления, действия которых могут вызвать преступность.
С помощью расчетов такого рода можно оценить вероятностное социокультурное влияние различных факторов на развитие личности и предположить, как себя будет вести человек, например, в деловом общении, объективно оценить, подходит ли он для государственного управления, или воинской службы.
Так же коэффициент определяет, правильно ли выбран индекс для подсчета коэффициентов бета и альфа. Если в % цифра ниже 75 к определенному индексу, значения бета и альфа к нему будут некорректны.
Индекс детерминации
Индекс детерминации – это квадрат инд. корреляции нелинейных связей. Этим значением характеризуют, на какое количество процентов моделью регрессии объясняются варианты показателей результативной переменной по отношению к своему среднему уровню.
Формула
![]()
Коэффициент детерминации скорректированный

Суть данного понятия состоит в следующем: этот индекс показывает долю дисперсии (общей) результативной переменной, объясняющей вариантами факторных переменных, включаемых в модель регрессии: (с увеличением, уменьшением).
Вариация признака определяется различными факторами, часть этих факторов можно выделить, если статистическую совокупность разделить на группы по определенному признаку. Тогда, наряду с изучением вариации признака по совокупности в целом, можно изучить вариацию для каждой из составляющих ее группы и между этими группами. В простом случае, когда совокупность разделена на группы по одному фактору, изучение вариации достигается посредством вычисления и анализа трех видов дисперсий: общей, межгрупповой и внутригрупповой.
Эмпирический коэффициент детерминации
Эмпирический коэффициент детерминации широко применяется в статистическом анализе и является показателем, представляющим долю межгруппопой дисперсии в результативного признака и характеризует силу влияния группировочного признака на образование общей вариации. Он может быть рассчитан по формуле:
Показывает долю вариации результативного признака у под влиянием факторного признака х, он связан с коэффициентом корреляции квадратичной зависимостью. При отсутствии связи эмпирический коэффициент детерминации равен нулю, а при функциональной связи - единице.
Например, когда изучается зависимость производительности труда рабочих от их квалификации коэффициент детерминации равен 0,7, то на 70% вариация производительности труда рабочих обусловлена различиями в их квалификации и на 30% - влиянием прочих факторов.
Эмпирическое корреляционное отношение - это квадратный корень из коэффициента детерминации. Отношение показывает тесноту связи между группировочным и результативным признаками. Эмпирическое корреляционное отношение принимает значения от -1 до 1. Если связи нет, то корреляционное отношение равняется нулю, т.е. все групповые средние равняются между собой и межгрупповой вариации нет. Значит, группировочный признак не влияет на образование общей вариации.
Если связь функциональная, то корреляционное отношение равняется единице. В таком случае дисперсия групповых средних равна общей дисперсии, т.е. внутригрупповой вариации нет. Это значит, что группировочный признак полностью определяет вариацию результативного признака.
Чем ближе значение корреляционного отношения к единице, тем сильнее и ближе к функциональной зависимости связь между признаками. Для качественной оценки силы связи на основе показателя эмпирического коэффициента корреляции можно использовать соотношение Чэддока.
Соотношение Чэддока
- Связь весьма тесная — коэффициент корреляции находится в интервале 0,9 — 0,99
- Связь тесная — Rxy = 0,7 — 0,9
- Связь заметная — Rxy = 0,5 — 0,7
- Связь умеренная — Rxy = 0,3 — 0,5
- Связь слабая — Rxy = 0,1 — 0,3



Популярное
- Создаём винные дрожжи своими руками в домашних условиях
- Для православных христиан наступает неделя, предшествующая великому посту
- Значение водных богатств и их охрана презентация
- Соотношение российских и американских званий
- Люди, изменившие ход мировой истории
- Храм Живоначальной Троицы на Воробьёвых горах
- Кто должен сдавать декларацию по налогу на имущество?
- Классическая вероятность и ее свойства
- Население и культура Австрии - сообщение (3 класс Окружающий мир)
- Гонорея в раннем детском возрасте